Гайды · Сергей Матусевич ·
Парсинг сайтов в Claude Code и Codex: открытый парсер Scrapling
Парсинг сайтов в Claude Code и Codex через Scrapling: что мерили в «785 раз быстрее» и как подключить. Внутри правила сбора и готовый промпт.
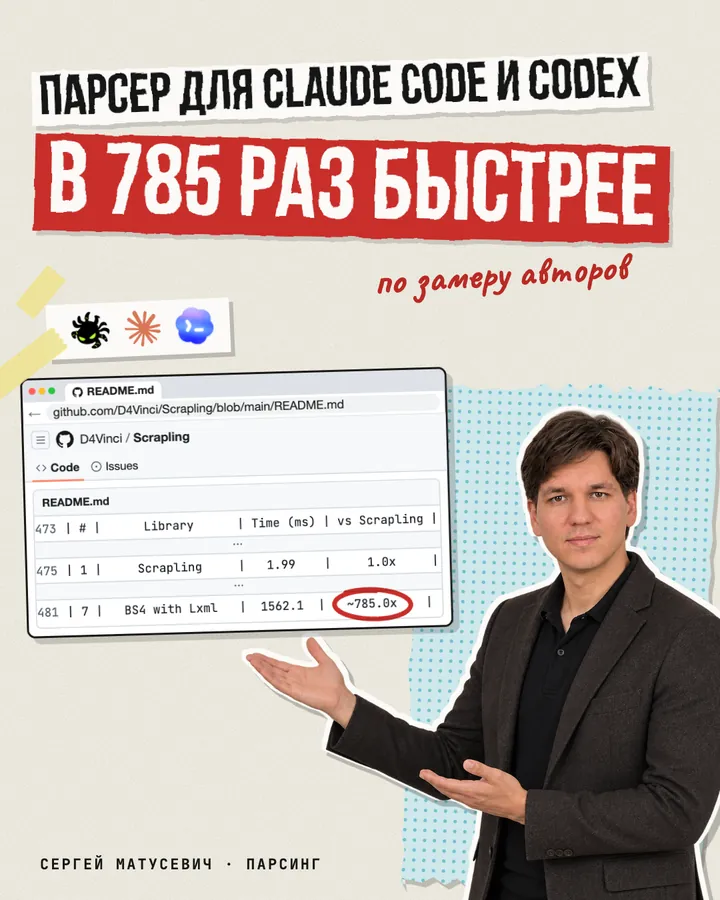
Для парсинга сайтов в Claude Code и Codex подходит Scrapling — открытая библиотека Python с лицензией BSD-3-Clause. Её сервер MCP даёт агенту 13 инструментов: агент сам скачивает страницы и достаёт из них данные. Парсер находит данные и после смены вёрстки, если ты заранее сохранил приметы элемента.
Гайд собран 15 октября 2026 по README, справке и коду Scrapling 0.4.15 и по справке Claude Code и Codex. Команды взяты из справки Scrapling слово в слово. Строку для Codex я собрал по образцу из справки Codex. Закреплённая версия записана по правилам pip.
Что в гайде
- Что умеет Scrapling
- Правда ли Scrapling в 785 раз быстрее?
- Как Scrapling находит данные после смены вёрстки?
- Как подключить Scrapling к Claude Code и Codex?
- Что можно собирать?
- Готовый промпт
Вопросы
Scrapling бесплатный?
Да, библиотека Scrapling бесплатна: её код открыт под лицензией BSD-3-Clause. Платных тарифов у неё нет. Токены Claude Code или Codex и прокси оплачиваешь ты.
Нужно ли уметь программировать, чтобы парсить сайты через Claude Code?
Нет. Для подключения нужен только терминал: две команды установки и одна команда подключения. Для своих скриптов на Scrapling нужен Python 3.10 или новее.
Чем Scrapling отличается от BeautifulSoup?
Scrapling кроме разбора HTML скачивает страницы, ищет элемент после смены вёрстки и подключается к агентам как сервер MCP. BeautifulSoup только разбирает HTML. Ещё Scrapling собирает данные с многих страниц своими «пауками».
Зачем Scrapling, если в Claude Code есть WebFetch?
Scrapling даёт агенту больше способов добыть данные, чем встроенный WebFetch. WebFetch читает страницу и переводит её в Markdown. Scrapling делает запросы без браузера, открывает страницы на скриптах в браузере, выбирает данные селектором и держит сессии.
Что Scrapling делает с проверкой Cloudflare Turnstile?
Авторы Scrapling пишут, что его скрытый браузер справляется с проверками Cloudflare Turnstile. Проверку ставит владелец сайта: так он закрывает данные от роботов. Такие данные мы не берём.
Можно ли парсить любой сайт?
Нет. Мы собираем только открытые данные и по правилам сайта. Сначала прочитай файл robots.txt и условия сайта. Личные данные людей не собирай: 152-ФЗ называет сбор частью их обработки. Базу сайта целиком не забирай: у её изготовителя есть своё право по статье 1334 ГК РФ. Это не юридическая оценка.
Где Scrapling хранит приметы элементов для адаптивного поиска?
Приметы лежат в файле SQLite elements_storage.db в папке пакета Scrapling. Свой путь задаёт параметр storage_args. Ключ записи — домен сайта и селектор.
Сколько инструментов у сервера MCP Scrapling?
В версии 0.4.15 у сервера MCP Scrapling 13 инструментов. Версия 0.5 пока в разработке. В ней 16 инструментов, часть имён другая. Этот гайд написан для версии 0.4.15.
Источники
- README Scrapling, проект Scrapling на GitHub, проверено 15.10.2026: замер скорости, установка, оговорка авторов.
- benchmarks.py, проект Scrapling на GitHub, 08.02.2026: как шёл замер скорости.
- Адаптивный поиск, документация Scrapling, проверено 15.10.2026: приметы, пределы, пример кода.
- parser.py, проект Scrapling на GitHub, проверено 15.10.2026: порог сходства 40 %, файл elements_storage.db.
- Репозиторий Scrapling, GitHub, проверено 15.10.2026: число звёзд, лицензия.
- scrapling/core/ai.py, проект Scrapling на GitHub, проверено 15.10.2026: 13 инструментов сервера MCP, проверки robots.txt в нём нет.
- Agent Skill, документация Scrapling, проверено 15.10.2026: команда установки навыка.
- Сервер MCP, документация Scrapling, проверено 15.10.2026: 13 инструментов, установка, команда для Claude Code.
- Scrapling 0.4.15, PyPI, 23.08.2026: версия и дата выпуска.
- Connect Claude Code to tools via MCP, Anthropic, проверено 15.10.2026: проверка подключения, предупреждение о внедрении команд.
- Model Context Protocol в Codex, OpenAI, проверено 15.10.2026: команда codex mcp add, файл настроек.
- Tools reference, Anthropic, проверено 15.10.2026: что делает WebFetch.
- RFC 9309. Robots Exclusion Protocol, IETF, сентябрь 2022: что такое robots.txt.
- Robots.txt specification, Google, проверено 16.10.2026: Crawl-delay не поддерживается.
- Директива Crawl-delay, Яндекс, проверено 15.10.2026: Яндекс не учитывает её с 22.02.2018.
- 152-ФЗ «О персональных данных», КонсультантПлюс, редакция от 26.07.2026: определение обработки, раскрытые данные.
- КоАП РФ, статья 13.11, КонсультантПлюс, редакция от 04.08.2026: штрафы.
- ГК РФ, статья 1334, КонсультантПлюс, редакция от 23.07.2025: право изготовителя базы данных.
- Кассация направила на пересмотр дело «ВКонтакте» против стартапа «Дабл», pravo.ru, 17.07.2018: ход дела.
- Books to Scrape, учебный сайт для парсинга, проверено 15.10.2026: строка «We love being scraped!».
- СИП утвердил мировое соглашение между «ВКонтакте» и Double Data, pravo.ru, 21.09.2022: итог дела.